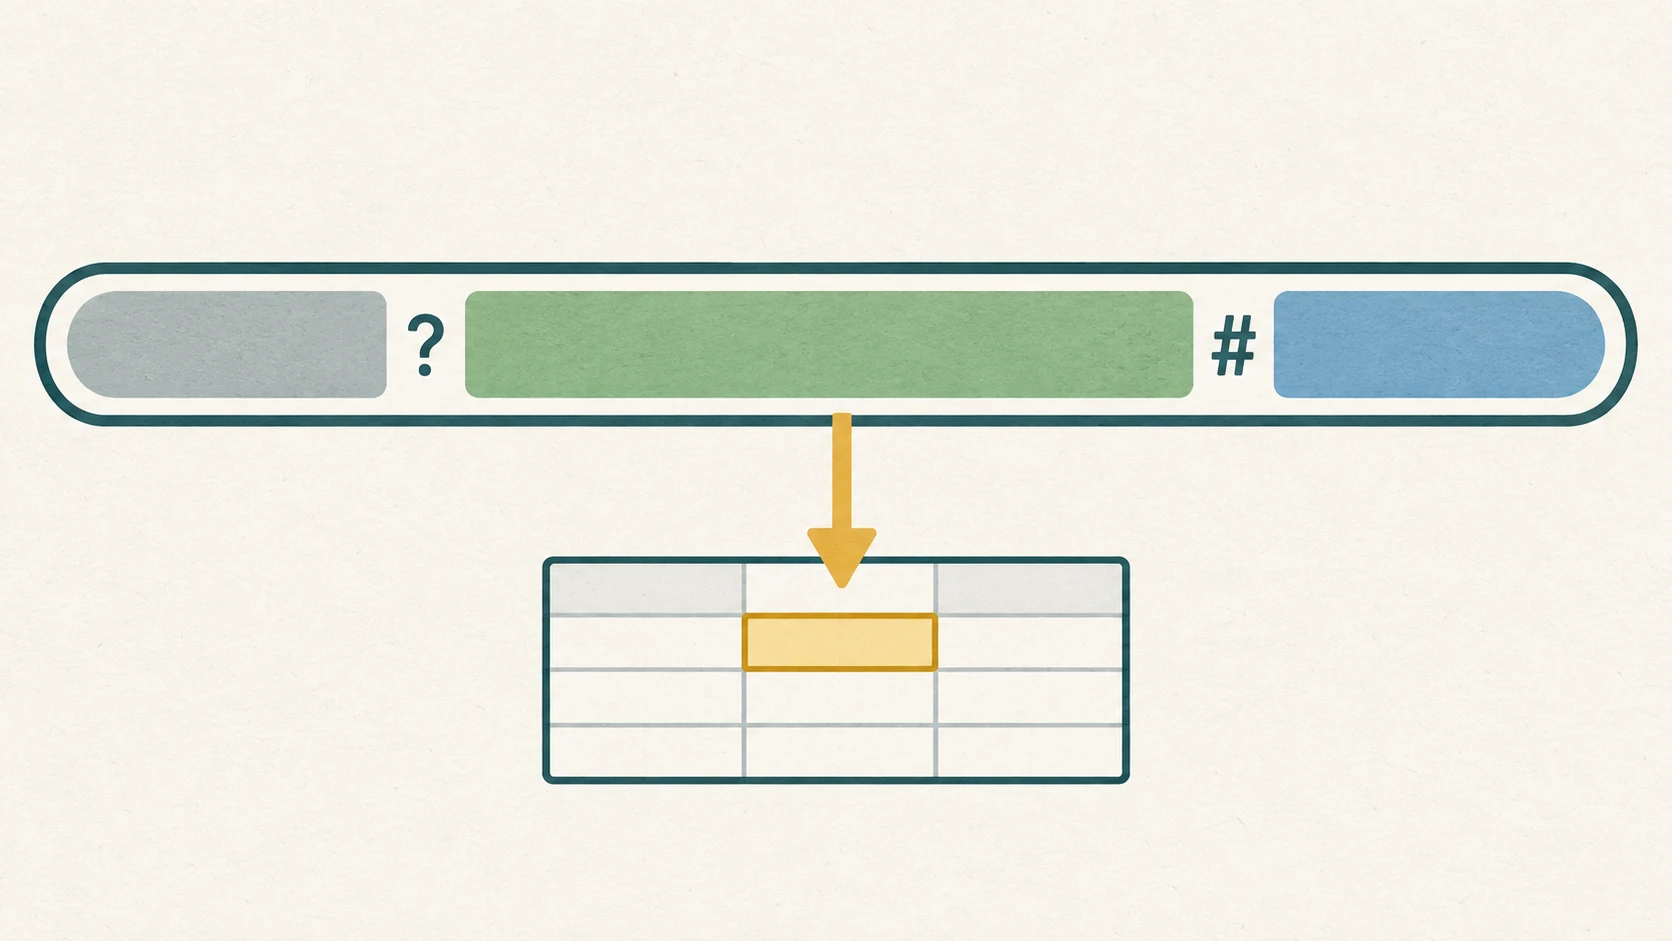
대표 이미지 설명: 주소의 ? 뒤 query와 # 뒤 fragment를 분리해 원본을 대조합니다. 아래 격자는 개념 표현이며 Google Sheets 실제 셀·추출 결과 화면이 아닙니다.
링크 목록에서 utm_source를 뽑을 때 URL 전체를 한 번에 검색하면 # 뒤 fragment의 가짜 키를 값으로 받아들일 수 있습니다. 원본 URL을 남기고 query 부분을 먼저 분리한 뒤 첫 값을 추출하세요. 누락, 값이 비어 있는 키, 반복된 키는 별도 검토 칸에 기록해야 합니다. 아래 수식은 Google의 REGEXEXTRACT 함수 설명, RE2 문법, RFC 3986의 query·fragment 구분을 바탕으로 구성했습니다. Python 3.14.7 표준 re에서 예제 15건을 로컬 검산했지만, Google Sheets 실계정 반환·오류 문구·로캘에서는 실행하지 않았습니다.
URL 전체에서 키를 찾으면 무엇을 잘못 뽑나요?
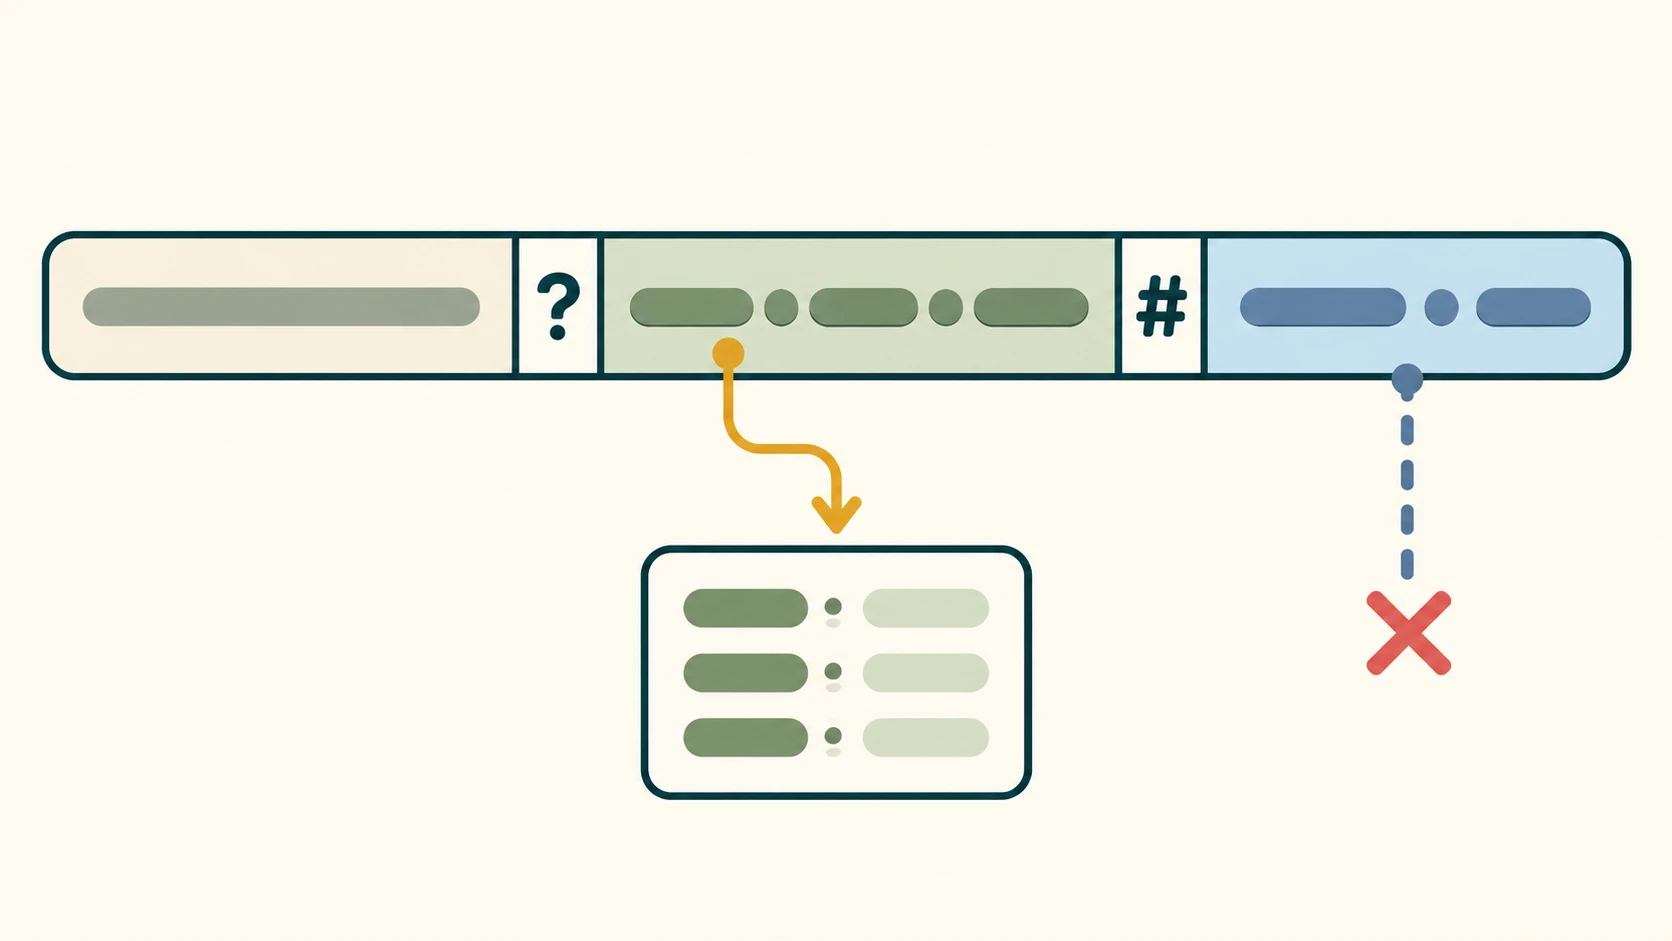
RFC 3986에서 query는 ? 뒤에 시작하고 # 앞에서 끝납니다. 이 글의 입력은 &로 구분된 키=값 형태의 비민감 URL로 제한합니다. & 키-값 구분은 이 예제의 규약이지 모든 URL query를 RFC가 그렇게 해석한다는 뜻은 아닙니다. RFC 3986 §3.4와 §3.5
전체 URL에 [?&]utm_source=([^&#]+)를 적용하면 https://example.com/h#section?utm_source=fake에서 fragment의 fake를 채택합니다. https://example.com/e?utm_source=&utm_source=two에서는 빈 첫 값을 건너뛰고 two를 채택합니다. 두 결과는 로컬 정규식 검산의 반례이며 Sheets에서 관측한 값이 아닙니다. 원본을 보존하고 # 앞의 query만 분리하면 첫 번째 위험을 줄일 수 있습니다. 빈 값을 허용하는 *를 쓰면 두 번째 경우에 첫 일치를 건너뛰지 않습니다.
 이미지 확대 보기
A열 원본을 남기고 query와 첫 값을 어떻게 분리하나요?
빈 시트의 A2에 https://example.com/a?utm_source=newsletter&utm_medium=email을 설명용 입력으로 넣으세요. B2와 C2에는 아래 수식을 각각 복사하고, 다음 행에도 채우세요. 이 수식은 https://example.com/...처럼 단순한 일반 URL 텍스트를 대상으로 합니다. RE2 문법의 앵커, 부정 문자 클래스, 비캡처 그룹, *만 사용하며 정규식 엔진 자체는 Python에서 검산했습니다.
B2에 입력할 수식
=REGEXEXTRACT(A2,"^[^?#]*\?([^#]*)")C2에 입력할 수식
=REGEXEXTRACT(B2,"(?:^|&)utm_source=([^&]*)")B열은 ? 뒤부터 첫 # 앞까지 query 원문을, C열은 소문자 utm_source=의 첫 일치에서 값 원문을 꺼내도록 설계했습니다. 공식 함수 문서에는 첫 일치와 캡처 그룹 반환이 설명돼 있습니다. 위 입력에서 로컬 검산은 B=utm_source=newsletter&utm_medium=email, C=newsletter였습니다. Sheets 화면에서 그대로 나온다고 실측 주장하지 않으니 먼저 샘플 셀로 확인하세요. B열에서 불일치·오류가 나면 A열이 URL 텍스트인지와 ?/# 위치를 확인하고, C열에서 불일치·오류가 나면 B열의 query와 정확한 소문자 키를 보세요. 로캘에 따라 수식 인수 구분자가 다를 수 있으며 이 글은 해당 설정을 시험하지 않았습니다. Google REGEXEXTRACT
누락·빈값·중복은 어떻게 구별하나요?
C열만 보고 확정하지 말고 A열 원본, B열 query, C열 추출값 또는 오류, D열 확인 필요 사유를 함께 적으세요. 다음 표의 ‘로컬 결과’는 Python 정규식 검사기에서 나온 값으로, Sheets 셀 화면의 오류/빈칸 표시가 아닙니다. 모든 주소는 설명용 example.com 입력입니다.
| A열 URL 끝 | B열 query 로컬 결과 | C열 첫 값 로컬 결과 | D열 확인 기준 |
|---|---|---|---|
/a?utm_source=newsletter&utm_medium=email |
utm_source=newsletter&utm_medium=email |
newsletter |
한 번 나온 키; 원본 대조 |
/c?ref=home |
ref=home |
일치 없음 | 키 누락. 빈 값과 다름 |
/d?utm_source=one&utm_source=two |
utm_source=one&utm_source=two |
one |
정확한 키 2회. 첫 값 자동 확정 금지 |
/e?utm_source=&utm_source=two |
utm_source=&utm_source=two |
빈 문자열 "" |
키 2회·첫 값 비어 있음. 둘째 값을 자동 채택 금지 |
/f?utm_source= |
utm_source= |
빈 문자열 "" |
키는 있지만 값이 비어 있음 |
/h#section?utm_source=fake |
일치 없음 | 일치 없음 | fragment의 가짜 키; query 없음 |
/i?ref=home#section&utm_source=fake |
ref=home |
일치 없음 | fragment의 가짜 키 제외 |
/n? |
빈 문자열 "" |
일치 없음 | 비어 있는 query와 query 없는 URL을 구별 |
특히 =REGEXEXTRACT(B2,"(?:^|&)utm_source=([^&]*)")의 *는 빈 값도 일치 대상으로 삼습니다. 로컬 검사에서 첫 빈 중복은 ""이고 키가 없으면 ‘일치 없음’이었습니다. Sheets가 실제로 이 빈 캡처를 어떻게 표시하고 불일치에 어떤 오류를 보여 주는지는 미확인입니다. 셀의 빈 모양만으로 두 상태를 확정하지 말고 B열에 utm_source=가 있는지, 같은 이름이 query에 몇 번 있는지 원문을 대조하세요. IFERROR(...,"")로 오류를 일괄 공백화하면 중요한 구분이 사라집니다. 중복 키의 첫 값은 함수의 첫 일치일 뿐 업무상 정답이 아닙니다. Google 함수 정의
 이미지 확대 보기
어떤 URL은 이 수식으로 처리하지 말아야 하나요?
utm_source=a%20b+c의 값은 로컬 검산에서 디코딩되지 않은 a%20b+c 그대로였습니다. UTM_SOURCE처럼 대문자인 키와 utm%5Fsource처럼 인코딩된 키도 이 정확한 소문자 패턴에서는 일치하지 않았습니다. 이 수식은 완전한 URL 파서, 퍼센트 디코더, 중복 키 해소기가 아닙니다. ?·#가 이스케이프된 복잡한 주소, 다른 query 규약, 실제 업무상 중복 우선순위가 있으면 원본 규칙을 정하고 적합한 URL 파서나 수집 단계에서 처리하세요.
이 예제는 광고 계정이나 분석 권한 없이 연습할 수 있지만, 값을 추출했다고 방문·전환 성과를 확인한 것은 아닙니다. 운영 토큰이나 고객 정보가 담긴 URL을 공개 예제에 넣지 마세요. 위치별 빈 필드 보존이 필요한 작업이라면 SPLIT의 연속 구분자와 빈 필드 글이 별개 질문에 답합니다.